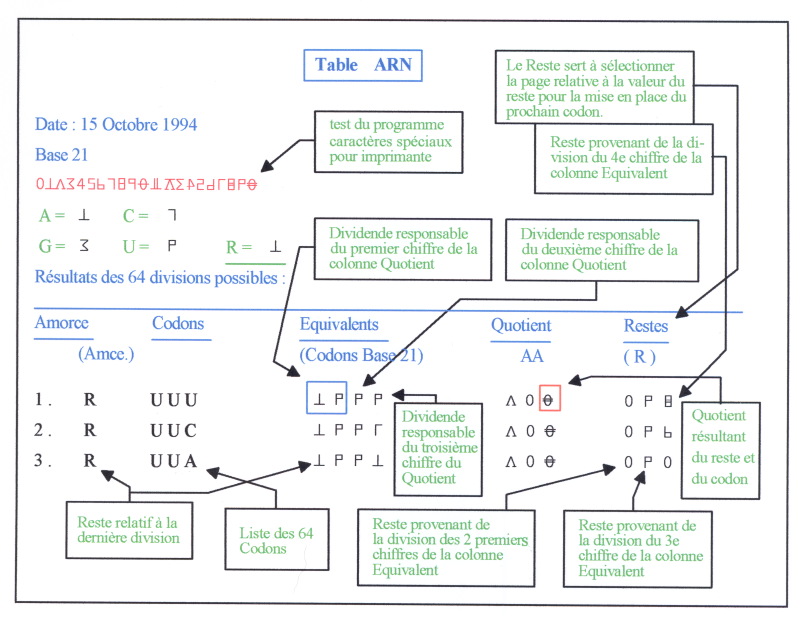
A partir de cela, la question qui se pose maintenant est : Si l'on veut se servir des acides aminés comme base de départ, comment construire un ARNm à partir d'une protéine et comment respecter le positionnement des acides aminés de la protéine ? ( Voir l’exemple de la page précédente :
'' Positionnement des acides aminés impliquant les codons appropriés'' )
Pour répondre à ces 2 questions, c'est alors que j'ai choisi de fragmenter l'ARNm par groupe de trois, dû aux codons qui sont composés de 3 bases, et de préfabriquer les réponses de divisions pour les 64 codons possibles obtenant par le fait même tous les données possibles en vue d'une réponse recherchée au niveau des acides aminés voulus, réponse servant à sélectionner les codons appropriés pour les acides aminés considérés en vue de l'assemblage de l'ARNm, c'est cette façon de faire qui me conduisit à la mise au point des tables d'ARN.
De ce fait, il m'est devenu possible à partir des tables d'ARN de fabriquer, tout en choisissant mes acides aminés, l'ARNm. Les tables d'ARNm qui regroupent les 64 codons possibles du code génétique actuel comprennent 20 pages résultant du " RESTE " possible à la fin de la division des 3 bases, " RESTE " qui présume du prochain groupe de 3 bases qui viendra s'ajouter pour la constitution d'un brin d'ARNm . Le " RESTE " est en quelque sorte l'amorce qui précisera laquelle des 20 pages de la table sera utilisée pour mettre en place le prochain acide aminé ainsi que son grou- pement de 3 bases. Ainsi il devient possible de mettre en place un ARNm tout en tenant compte des résidus d'une protéine .


